Entre el 1 y el 2 de septiembre de 2026 se estrenaron tres modelos de IA relevantes: Claude Fable 5.1 (Anthropic), Muse Spark 1.3 (Meta) y Gemini 3.8 Flash junto a su variante Cyber (Google). Tres laboratorios, 48 horas y el mismo titular en casi todos lados: más inteligencia, más capacidad agéntica, mejores benchmarks.
Pero el dato que de verdad afecta a la factura de una pyme o una startup está en la letra chica: el precio por millón de tokens dejó de predecir cuánto cuesta terminar una tarea. Los tres lanzamientos lo demuestran, cada uno a su manera.
Este artículo se queda en lo publicado por Artificial Analysis, Xataka, Unite.AI y la cobertura recogida por The Verge, Ars Technica y VentureBeat. Sin cifras inventadas ni promesas de ahorro que nadie midió.
Claude Fable 5.1 (Anthropic). Es su modelo más capaz hasta la fecha: 66 puntos en el Artificial Analysis Intelligence Index, por delante de Opus 5 (63) y de GPT‑5.6 Sol y Grok 4.6 (61). Mejora sobre todo en programación, investigación científica y tareas agénticas largas. Con un detalle incómodo: Fable 5.1 y Mythos 5.1 pertenecen a la misma clase de modelo, pero Mythos —con capacidades sensibles de ciberseguridad— queda reservado a socios y organizaciones de confianza.
Muse Spark 1.3 (Meta). Cuarto modelo Muse Spark en cinco meses, publicado el 2 de septiembre en Muse Code y en la Meta Model API. La variante disponible, xhigh, entra con 61 puntos (empatada con GPT‑5.6 Sol max y Grok 4.6 high); la variante max, en preview limitado para socios, llega a 62. Sus ganancias vienen casi todas de trabajo agéntico y capacidades científicas.
Gemini 3.8 Flash y 3.8 Flash Cyber (Google). Tercer Flash en seis semanas. La versión estándar es un modelo «obrero» para tareas agénticas, desarrollo de software y razonamiento multipaso: 59 puntos en el índice, 1 millón de tokens de contexto, 64.000 de salida y niveles de esfuerzo ajustables (bajo, medio, alto). La variante Cyber, afinada para descubrir y parchear vulnerabilidades, no es de acceso general: se entrega a «defensores de confianza» dentro del programa Fairwind, que según The Verge ya cuenta con 650 miembros.
Aquí está el giro. Artificial Analysis mide el coste por tarea del Intelligence Index, no solo la tarifa por token. Y los números se separan del marketing:
Y el patrón se repite incluso cuando la tarifa no se toca: Muse Spark 1.3 (xhigh) cuesta más por tarea que Muse Spark 1.2 (0,55 frente a 0,40 USD) con el mismo precio por token, porque consume ~57% más tokens de entrada en evaluaciones agénticas.
La conclusión práctica es simple e incómoda: un modelo puede bajar de precio y subirle la factura. Lo que cambió no es la tarifa, es cuántos tokens y cuántos turnos gasta el modelo para llegar al resultado.
No necesita un equipo de MLOps para hacer esto bien. Necesita tres flujos representativos y disciplina para medir lo mismo en todos:
Con estos datos, la decisión razonable para una empresa pequeña no es «el mejor modelo», sino repartir por tipo de trabajo:
Si está montando o rehaciendo su operación digital y quiere que la IA entre por donde deja dinero —catálogo, atención, contenido, automatizaciones— en Presticorp aterrizamos eso según la etapa: pymes, startups y ecommerce. La regla que aplicamos es la misma de este artículo: primero se mide el coste por tarea terminada, después se escala.
Tres modelos en 48 horas y ninguno se vende por lo que más importa: lo que cuesta terminar el trabajo. Fable 5.1 es el más inteligente del ranking y también el más caro por tarea; Muse Spark 1.3 (xhigh) es el más eficiente entre los que puntúan 59 o más; Gemini 3.8 Flash bajó de categoría de precio pero subió su consumo real.
Elija esta semana un solo flujo de su negocio, córralo veinte veces en dos modelos y anote coste, tiempo y aciertos. Ese cuaderno vale más que cualquier tabla de benchmarks, porque mide su trabajo, no el de un laboratorio.
Nota editorial: puntuaciones del Artificial Analysis Intelligence Index, costes por tarea (3,76 / 0,55 / 0,58 / 0,63 / 0,68 / 0,94 / 0,95 / 1,23 USD), tarifas por millón de tokens, la rebaja del 75% en lectura de caché, el +40% de coste real de 3.8 Flash y las fechas de precio introductorio provienen de las fuentes citadas (1–2 de septiembre de 2026). No se estiman ahorros propios ni resultados de adopción.
Enviando comentario…
 EmiteDocs
Diplomas en lote: 3/semana gratis, hasta 1000 por $500. Contratos: desde $199, hasta 100.
 CrearPlantillas
Editor visual. 2 gratis/mes, 5/semana con cuenta, o 20 descargas por $69 MXN.
 TuRSVP
Invitaciones con RSVP. Desde $299 MXN, pago único.
 Minitareas
Tableros con Google. Libre: 1 tablero. Pro: $249 MXN al mes.
 Cotización de páginas web
Arma tu sitio por módulos y cotiza en MXN. Usarlo no tiene costo.
 Convertidor de formatos
Convierte Excel, Word, PDF e imágenes. $150 MXN al mes, hasta 200.
 Monitor Global
Clima, sismos, huracanes y tsunamis. Consulta gratis.
 Promo a la vista
Catálogo gratis. Resumen gratis o desde $200/mes. Comida destacada: $500/mes.
 Ravicom
Restaurantes y platillos. Buscar y registrar es gratis.
Si tu proyecto requiere una solución más enfocada, entra directo a la landing ideal para tu negocio y envíanos tu información en el formulario correspondiente.
Ofertas vigentes del catálogo, de la más nueva a la más antigua.
Ver promociones Cupón SaaS Cumpy Precio Fundador: tesorería, facturación y conciliación SPEI para PyMEs −30% ($690/mes, antes $980; prueba antes del 31 oct 2026)
Suscripción SaaS Cumpy (software mexicano de tesorería SPEI, facturación y conciliación para PyMEs), plan Fundador Esencial con pago anual
 Tenis ASICS GLIDERIDE MAX 2 hombre Cold Moss/Cobalt Burst a $3,009.30 (−30%)
Tenis de running ASICS GLIDERIDE MAX 2 para hombre, color Cold Moss/Cobalt Burst, modelo 1011C156.400
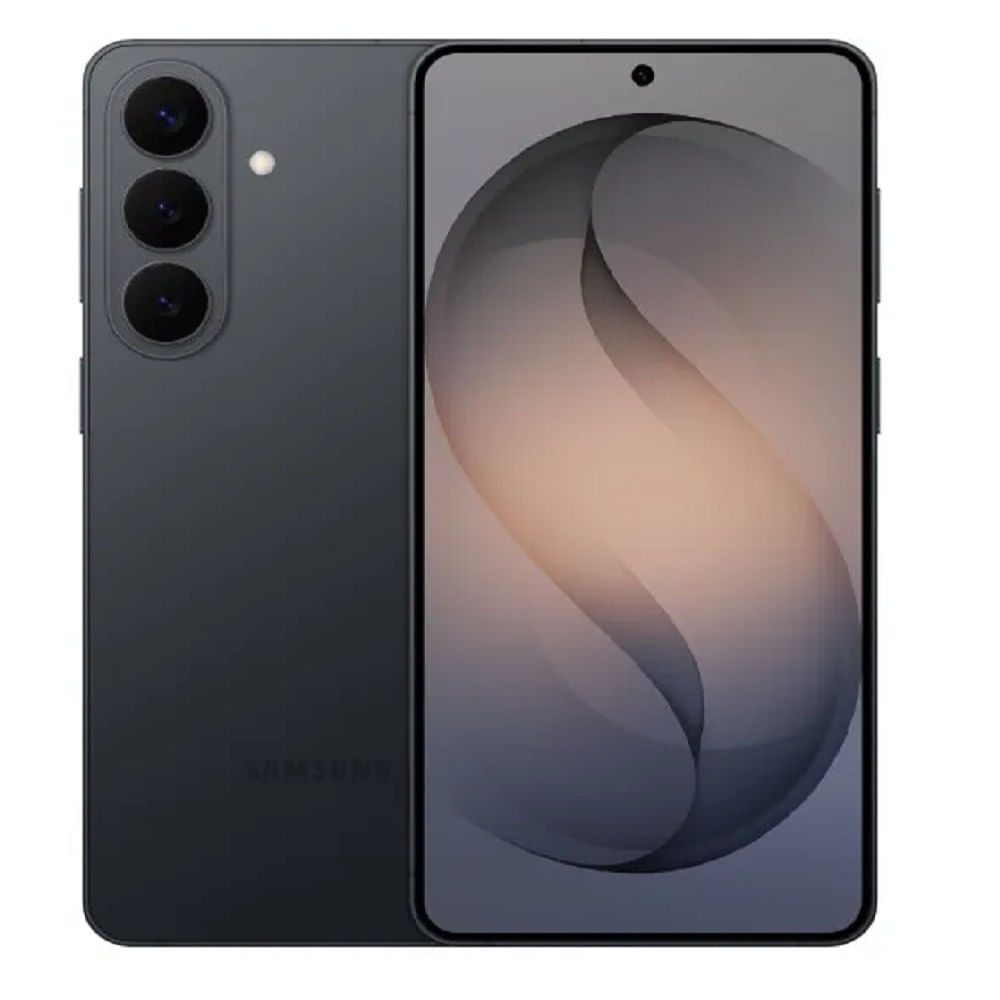 Samsung Galaxy S26 con IA (Galaxy AI) 256 GB, 12 GB RAM, negro a $15,999 en Mixup (antes $22,499, −29%)
Celular Samsung Galaxy S26 de 256 GB y 12 GB de RAM en color negro, con funciones de inteligencia artificial Galaxy AI
 Minisplit Whirlpool Inverter 1 tonelada Solo Frío 220 V (WA5059Q) a $7,999 (−25%)
Aire acondicionado minisplit Whirlpool Inverter Xpert Energy Saver de 1 tonelada (11,000 BTU), solo frío, 220 V, blanco, modelo WA5059Q

0 Comentarios